Pertanyaan Storage yang Pasti Muncul di Setiap Fitur RAG
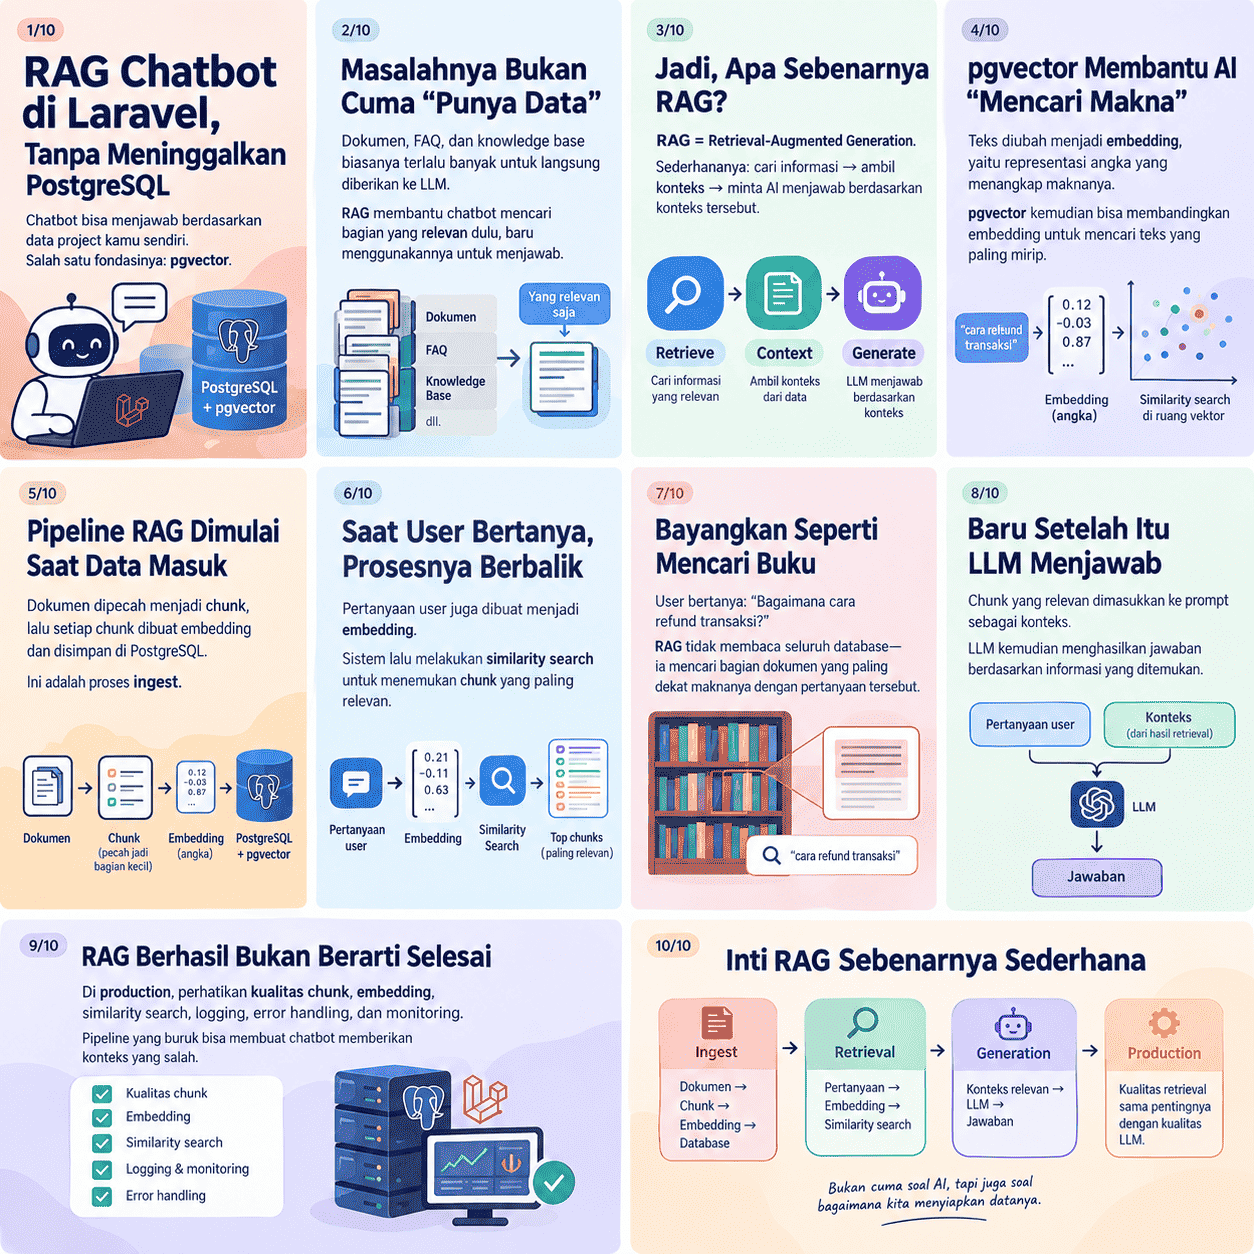
Chunker sudah jadi, model embedding sudah dipilih, dan pipeline Retrieval-Augmented Generation (RAG) mulai terbentuk. Lalu muncul pertanyaan klasik: vektornya disimpan di mana? Refleks banyak tim adalah langsung menambahkan vector database khusus di samping PostgreSQL yang sudah berjalan. Padahal untuk sebagian besar beban kerja nyata, seperti pencarian dokumentasi, knowledge base internal, atau klasifikasi tiket support, PostgreSQL dengan ekstensi pgvector sudah lebih dari cukup.
Sebelum memilih storage, ada satu pertanyaan yang lebih mendasar: apakah kamu benar-benar butuh retrieval? Anthropic mencatat bahwa jika knowledge base kamu lebih kecil dari sekitar 200.000 token (kira-kira 500 halaman), seluruh isinya bisa langsung dimasukkan ke prompt, apalagi dengan prompt caching yang memangkas latensi dan biaya secara signifikan. Artikel ini ditujukan untuk kasus ketika data kamu sudah melewati batas itu.
Apa yang Kamu Korbankan Saat Menambah Service Terpisah
Menambahkan vector database bukan sekadar menambah satu dependensi. Kamu menambah satu sistem terdistribusi baru, lengkap dengan konsekuensinya:
- Pipeline sinkronisasi. Dokumen hidup di Postgres, embedding hidup di service lain. Setiap insert, update, dan delete harus ditulis ke dua tempat. Jika salah satu gagal, kamu punya dokumen tanpa embedding atau vektor yatim yang menunjuk ke dokumen yang sudah dihapus. Solusinya biasanya retry logic yang rumit atau job rekonsiliasi di background.
- Kredensial tambahan. Satu secret lagi untuk disimpan, dirotasi, dan dibatasi aksesnya, ditambah konfigurasi koneksi dan retry per service.
- Deploy dan monitoring tambahan. Satu dashboard lagi, satu alerting lagi, dan satu komponen lagi yang bisa down secara independen dari aplikasi utama.
- Konsistensi yang melemah. Hubungan antara data aplikasi dan index pencarian berubah dari transaksional menjadi eventual.
Menariknya, keuntungan performa yang dijanjikan sering tidak terasa oleh user. Menurut Encore, langkah vector search umumnya memakan 5–50 ms, panggilan API embedding 100–300 ms, dan generasi LLM 500 ms hingga 3 detik. Selisih antara 2 ms dan 10 ms di tahap pencarian praktis tidak terlihat.
| Aspek | Vector DB Terpisah | Postgres + pgvector |
|---|---|---|
| Jumlah service | 3 (Postgres, vector DB, API embedding) | 2 (Postgres, API embedding) |
| Sinkronisasi | Wajib | Tidak ada |
| Konsistensi | Eventual | Transaksional |
| Mode kegagalan | Vektor yatim, embedding basi | Kegagalan Postgres standar |
pgvector dalam Praktik
pgvector menambahkan tipe kolom vector, operator jarak, dan index approximate nearest neighbor langsung ke Postgres. Skema RAG sederhana bisa terlihat seperti ini:
CREATE EXTENSION IF NOT EXISTS vector;

CREATE TABLE documents (
  id bigserial PRIMARY KEY,
  tenant_id bigint NOT NULL,
  title text NOT NULL,
  status text NOT NULL DEFAULT 'draft',
  updated_at timestamptz NOT NULL DEFAULT now()
);

CREATE TABLE chunks (
  id bigserial PRIMARY KEY,
  document_id bigint NOT NULL REFERENCES documents(id) ON DELETE CASCADE,
  content text NOT NULL,
  embedding_model text NOT NULL,
  embedding vector(1536) NOT NULL
);
Operator jarak yang tersedia:
| Operator | Jarak | Catatan |
|---|---|---|
<-> |
L2 (Euclidean) | Default di banyak contoh |
<#> |
Inner product negatif | Nilainya negatif karena Postgres hanya mendukung index scan ASC |
<=> |
Cosine | Similarity = 1 - (a <=> b) |
<+> |
L1 (taxicab) | Sejak 0.7.0 |
<~> / <%> |
Hamming / Jaccard | Untuk vektor biner |
Kekuatan utamanya ada di sini: filter metadata, join, dan pencarian kemiripan berjalan dalam satu query SQL.
SELECT c.id, c.content, d.title,
       1 - (c.embedding <=> $1) AS similarity
FROM chunks c
JOIN documents d ON d.id = c.document_id
WHERE d.tenant_id = $2 AND d.status = 'published'
ORDER BY c.embedding <=> $1
LIMIT 20;
Agar index terpakai, query wajib memiliki ORDER BY berupa operator jarak dengan urutan ascending plus LIMIT. Menulis ORDER BY 1 - (embedding <=> $1) DESC akan membuat planner mengabaikan index.
Satu bonus lagi: riset Contextual Retrieval dari Anthropic menunjukkan bahwa menggabungkan embedding dengan pencarian leksikal (BM25) lebih baik daripada embedding saja. Kombinasi contextual embeddings dan contextual BM25 menurunkan kegagalan retrieval top-20 sebesar 49%, dan 67% jika ditambah reranking. Di Postgres, full-text search bawaan bisa mengisi peran sisi leksikal ini (bukan implementasi BM25 yang identik, tetapi fungsinya serupa), lalu hasilnya digabung dengan Reciprocal Rank Fusion. Semuanya tetap dalam satu database.
Memilih Index: Exact, IVFFlat, atau HNSW
Secara default pgvector melakukan exact search yang memberi recall sempurna. Index approximate menukar sedikit recall dengan kecepatan, dan hasil query bisa berbeda setelah index ditambahkan.
| Index | Recall | Build & Memori | Parameter Utama |
|---|---|---|---|
| Exact (tanpa index) | 100% | Tanpa biaya index, tapi scan linear | max_parallel_workers_per_gather |
| IVFFlat | Lebih rendah pada kecepatan yang sama | Build cepat, memori lebih kecil | lists, ivfflat.probes (default 1) |
| HNSW | Trade-off kecepatan-recall terbaik | Build lebih lambat, memori lebih besar | m=16, ef_construction=64, hnsw.ef_search=40 |
IVFFlat membagi vektor ke dalam beberapa list lalu hanya memindai list terdekat. Buat index setelah tabel berisi data, mulai dengan lists = rows/1000 hingga 1 juta baris dan sqrt(rows) di atasnya, lalu set probes sekitar sqrt(lists).
HNSW membangun graf berlapis. Tidak ada tahap training sehingga bisa dibuat pada tabel kosong. Build jauh lebih cepat jika graf muat di maintenance_work_mem.
CREATE INDEX CONCURRENTLY ON chunks USING hnsw (embedding vector_cosine_ops);
Hitung kebutuhan memorinya. Satu vector memakan 4 * dimensi + 8 byte, jadi vektor 1.536 dimensi butuh 6.152 byte. Satu juta chunk berarti sekitar 6,2 GB data vektor sebelum index. halfvec memangkasnya menjadi 3.080 byte, dan binary quantization hanya sekitar 200 byte per vektor (dengan re-ranking memakai vektor asli untuk menjaga recall). Perhatikan juga batas index: vector hanya bisa diindeks hingga 2.000 dimensi dan halfvec hingga 4.000. Model embedding 3.072 dimensi perlu expression index halfvec.
Jebakan yang sering terlewat: pada index approximate, filter WHERE diterapkan setelah index dipindai. Jika kondisi hanya cocok dengan 10% baris dengan ef_search default 40, rata-rata hanya 4 baris yang lolos. Solusinya adalah iterative index scan (sejak 0.8.0) via SET hnsw.iterative_scan = strict_order, partial index untuk nilai filter yang sedikit, atau partisi LIST per tenant untuk isolasi multi-tenant. Pantau recall secara berkala dengan membandingkan hasil approximate terhadap exact search menggunakan SET LOCAL enable_indexscan = off.
Ambang Skala: Kapan Vector Database Khusus Mulai Layak
Tabel berikut menggabungkan data dari sumber dengan heuristik praktis. Anggap batasnya sebagai panduan, bukan hukum.
| Ukuran/Kondisi | Rekomendasi |
|---|---|
| Knowledge base di bawah ~200 ribu token | Masukkan ke prompt dengan prompt caching, tanpa RAG |
| Ribuan hingga puluhan ribu vektor | pgvector, exact search sudah cukup |
| Ratusan ribu hingga beberapa juta vektor | pgvector + HNSW (benchmark yang dikutip Encore: di bawah 20 ms pada 1 juta vektor, recall di atas 95%) |
| Puluhan juta vektor | Masih bisa di pgvector dengan halfvec, binary quantization, partisi, replika, atau sharding (Citus, PgDog), tetapi biaya tuning mulai terasa |
| Miliaran vektor, write throughput ekstrem, isolasi per tenant skala besar, autoscaling tanpa tuning | Vector database khusus mulai sepadan |
Sinyal nyata untuk pindah bukan sekadar jumlah baris, melainkan saat index HNSW tidak lagi muat di memori server yang masuk akal, saat rebuild dan vacuum index mengganggu operasional, atau saat kebutuhan filter multi-tenant membuat recall turun dan partisi mulai tidak terkelola.
Menjaga Dokumen dan Embedding Tetap Konsisten dalam Satu Transaksi
Ini keuntungan paling besar dari pgvector: dokumen dan embedding-nya bisa ditulis dalam satu transaksi ACID. Tidak ada kondisi setengah jadi yang terlihat oleh query pencarian. Polanya:
- Hitung embedding di luar transaksi. Panggilan API embedding memakan ratusan milidetik, dan menahan transaksi terbuka selama network call akan mengunci baris terlalu lama.
- Buka transaksi, simpan dokumen, hapus chunk lama, masukkan chunk baru beserta embedding-nya.
- Commit. Jika ada langkah yang gagal, semuanya di-rollback.
Contoh di Laravel:
// Panggilan jaringan dilakukan sebelum transaksi dibuka
$vectors = $embedder->embedMany($chunks);

DB::transaction(function () use ($doc, $chunks, $vectors) {
    $doc->save();
    DB::table('chunks')->where('document_id', $doc->id)->delete();

    foreach ($chunks as $i => $chunk) {
        DB::table('chunks')->insert([
            'document_id' => $doc->id,
            'content' => $chunk,
            'embedding_model' => 'text-embedding-3-small',
            'embedding' => '[' . implode(',', $vectors[$i]) . ']',
        ]);
    }
});
Beberapa detail yang menyelamatkan kamu di produksi: simpan nama model di kolom embedding_model agar migrasi ke model baru bisa bertahap; simpan hash konten untuk melewati re-embedding jika teks tidak berubah; dan jika dua update bisa terjadi bersamaan, cek versi atau updated_at di dalam transaksi supaya embedding dari konten lama tidak menimpa yang baru. Karena ON DELETE CASCADE, menghapus dokumen otomatis menghapus semua vektornya, jadi tidak ada vektor yatim.
Kesimpulan
Untuk backend engineer yang sedang merancang storage fitur AI, titik awal yang paling rasional adalah Postgres yang sudah kamu jalankan. pgvector memberi operator jarak, index HNSW dan IVFFlat, filter dalam SQL yang sama, hybrid search dengan full-text search, dan yang terpenting, konsistensi transaksional tanpa pipeline sinkronisasi. Vector database khusus punya tempatnya, yaitu di skala miliaran vektor dan beban tulis ekstrem. Tapi pindahlah ketika metrik kamu menuntutnya, bukan karena refleks arsitektur. Butuh bantuan menyiapkan server Postgres dengan pgvector atau membangun fitur AI di website kamu? Tim katili.dev siap membantu.